2026年10月2日 星期五

福岡五天四夜家庭自由行:AI 排行程後,現場到底好不好用?

今年七月東京自由行之後,福岡五天四夜是我們第二次讓 AI 家庭管家「蝦蝦」參與規劃。這篇不打算寫成逐日遊記,而是整理兩次實際旅行後,我認為一般人真正用得上的 AI 排行程方法、提示詞與避雷心得。

先說結論:AI 很適合當行程助理,但不適合被當成全知全能的領隊。它最有價值的地方,不是一次產生看起來很豐富的景點清單,而是能記住一家人的習慣、維護已確認的資訊,並在下雨、排隊或交通延誤時迅速重排。

AI龍蝦家庭管家與家人一起規劃福岡及北九州自由行
這次測試的重點,不只是AI會不會排行程,而是現場出狀況後能不能把行程救回來。

一、不要先問「福岡有哪些景點」,先教 AI 你們怎麼旅行

同一座城市,不同家庭需要的行程可能完全不同。我們家一天通常吃兩餐,以早午餐和晚餐為主;屋台、甜點或消夜則看體力決定。逛到模型、玩具、生活雜貨店時,我們也會比一般旅客停留更久。

如果只叫 AI「排一份福岡五日行程」,它只能用網路上的平均值猜測,結果通常是景點很多、轉場很漂亮,但實際走起來一直趕。

比較有效的做法,是先提供一份家庭旅遊設定:

我們是四人家庭,一天以早午餐和晚餐兩餐為主;喜歡模型、玩具、生活雜貨與大型商場,逛街速度偏慢。每天最多安排兩個主要區域,晚上保留彈性,不為了完成清單而趕路。請先記住這些條件,再開始排行程。

這段設定不必每次重打。若使用的 AI 能保存偏好,就把它當成長期規則;不能保存時,也可以放在自己的行程範本最上方。

二、把「喜歡慢慢逛」改寫成可計算的規則

AI 聽得懂偏好,卻未必知道「慢慢逛」究竟是三小時還是七小時。這次最明顯的例子就是 LaLaport 福岡:原本抓四個多小時,實際碰上週末活動、鋼彈與各類店鋪後,時間完全不夠。

旅行結束後,我們把經驗改寫成下一次可直接使用的規則:

  • 一般大型商場至少預留五至六小時。
  • LaLaport 這類有主題設施、活動和用餐需求的商場,抓六至七小時,甚至視為當日主行程。
  • 一天最多安排兩個主要區域,避免一直換車。
  • 重要餐廳前不安排容易超時的購物點。
  • 回程日保留整理行李、退房及交通緩衝。

這是讓 AI 越用越準的關鍵:不要只告訴它哪裡排錯,也要把錯誤轉成數字或判斷規則。

三、把行程分成四種層級,才知道臨時該刪什麼

我們後來不再把所有景點視為同等重要,而是分成四類:

  • 硬性錨點: 已購票、已訂位、指定班次、只能在特定時間完成的活動。
  • 主要行程: 當天最想去的景點或商場,原則上保留。
  • 彈性項目: 屋台、咖啡店、順路購物,可依體力與天氣決定。
  • 備案: 下雨、店休、誤點或排隊過長時才啟用。

這個分類比精確到每十分鐘的時間表更重要。LaLaport 逛太久後,我們保留櫛田神社、晚餐和 Canal City,取消較晚的屋台;不是把後面所有行程一起延後,而是照優先順序刪減。

可以直接這樣問 AI:

現在比原訂時間晚兩小時,請不要把全部行程順延。先保留已訂位項目和最重要的景點,再依交通距離、營業時間與體力,列出建議刪除順序。

四、跨城市移動後,不要立刻接一個不能遲到的預約

這趟最具體的教訓,是由布院之森原訂 19:27 抵達博多,後面接 19:45 的晚餐訂位。帳面上餐廳離車站很近,看起來勉強可行;但大雨讓列車延誤,途中一度停在豐後森、天瀨一帶,原本精準的銜接立刻失效。

因此,往後遇到新幹線、特急列車、飛機或跨城市巴士,我會要求 AI:

  • 抵達後至少預留四十五至九十分鐘緩衝。
  • 若交通路線容易受天候影響,晚餐改選可現場候位或能彈性改時段的店。
  • 同時列出「準時抵達」與「延誤一小時」兩個版本。
  • 先確認取消規則,避免因延誤產生額外費用。

好的行程不是每一段都接得剛剛好,而是其中一段失敗時,後面不會全部倒下。

五、雨天備案應該在出發前就排好,不是下雨後才從零開始

福岡旅行碰上雨勢後,原本的大濠公園、舞鶴公園就不適合硬走。我們改成天神地下街、百貨、電器與收藏店巡禮,動線集中、能避雨,也符合家人的興趣。

規劃時可以要求 AI 為每一天建立兩條互斥路線:

請為這天各做一份晴天版與雨天版。兩版需使用相同的已訂位餐廳,雨天版以室內景點和地下街為主,並標示最晚何時要決定切換。

重點是不要把兩套內容全塞在同一張主行程裡,否則表格看起來像有十個景點,旅行時反而不知道該走哪一套。備案不是次等行程,而是當天條件下更適合的主方案。

六、旅行現場問 AI,要提供「現在的狀態」

現場臨時問「接下來去哪?」通常不夠。AI 若不知道位置、時間、排隊長度、天氣與大家的體力,就很容易提出不切實際的建議。

我現在會用這種格式:

現在 17:40,我們在博多祇園鉄なべ排隊,預估一小時後吃完。外面下雨,明早要早起,大家體力普通。原本還有 Canal City 和屋台,請依營業時間、交通與必要性,給我兩個方案並說明應刪哪一個。

只要把狀態交代清楚,AI 就能從「重新排一整天」改成真正有用的「下一步決策」。

七、AI 的答案要能被驗證,尤其是訂位與交通規則

出發前曾判斷日本餐廳的 TableCheck 預約可能需要日本手機號碼,實際操作後才發現台灣手機也能完成訂位。這類規則若只靠搜尋摘要或過去經驗,很容易把「部分店家限制」誤認成「所有店家都不行」。

較安全的做法是:

  • 營業時間、票價、班次與休館日,以官方網站為準。
  • 預約資格實際操作到送出前一步,再判斷是否可用。
  • 要 AI 同時附上資料日期,避免使用過期資訊。
  • 未確認內容明確標示「待確認」,不要寫得像已完成。

AI 應該幫忙縮小查證範圍,而不是取代查證。

八、把聊天內容整理成真正能在旅途中使用的工具

如果所有資訊只留在聊天室,到了現場仍要一直往上翻。我們使用固定的 12 欄試算表,整理日期、時段、區域、地點、交通、地址、餐點、訂位資訊、用餐提示與費用;已訂位和已購票的內容則用 粗體紅字 標示。

每次修改後,還會請 AI 回讀檢查:

  • 日期與星期是否一致。
  • 交通時間是否合理。
  • 地址、訂位時間與人數是否正確。
  • 費用公式有沒有被文字或空白列破壞。
  • 重要資訊樣式是否仍保留。

這個步驟很像程式更新後的測試。AI 能寫入表格,不代表寫完就一定正確;一定要再讀一次確認。

九、照片也能成為現場查詢入口

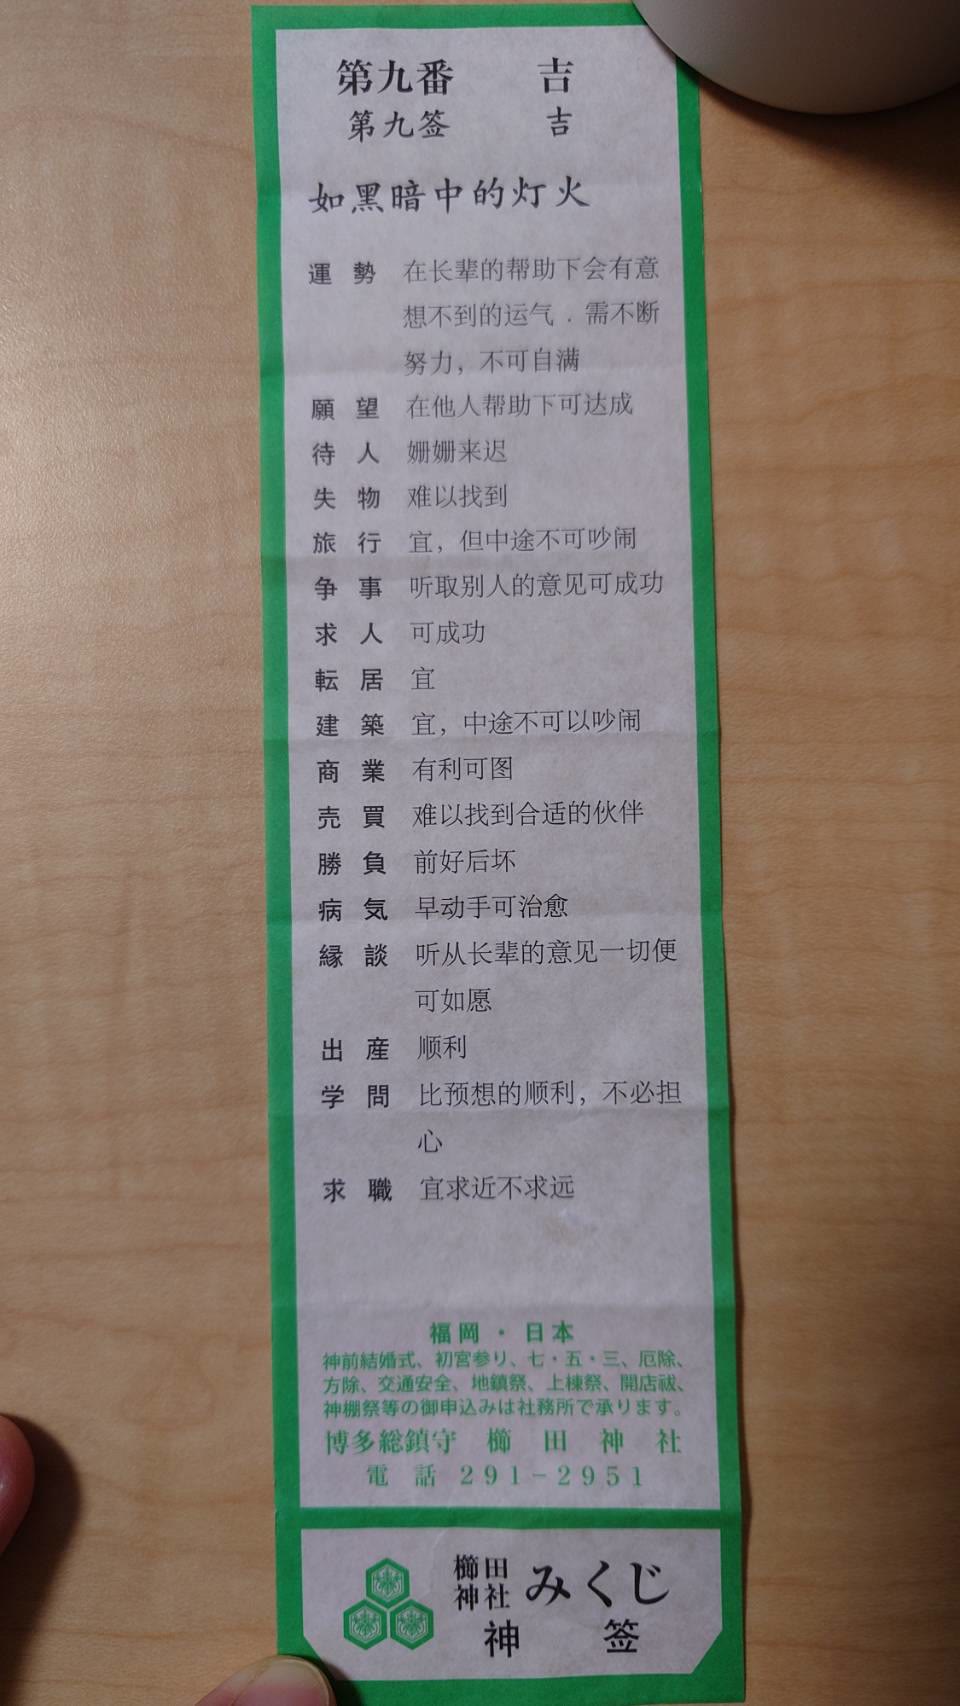
AI 的用途不只排行程。旅行途中看到陌生店家、商品、折價券或籤詩,我們會直接拍照請它辨識、翻譯與整理重點。

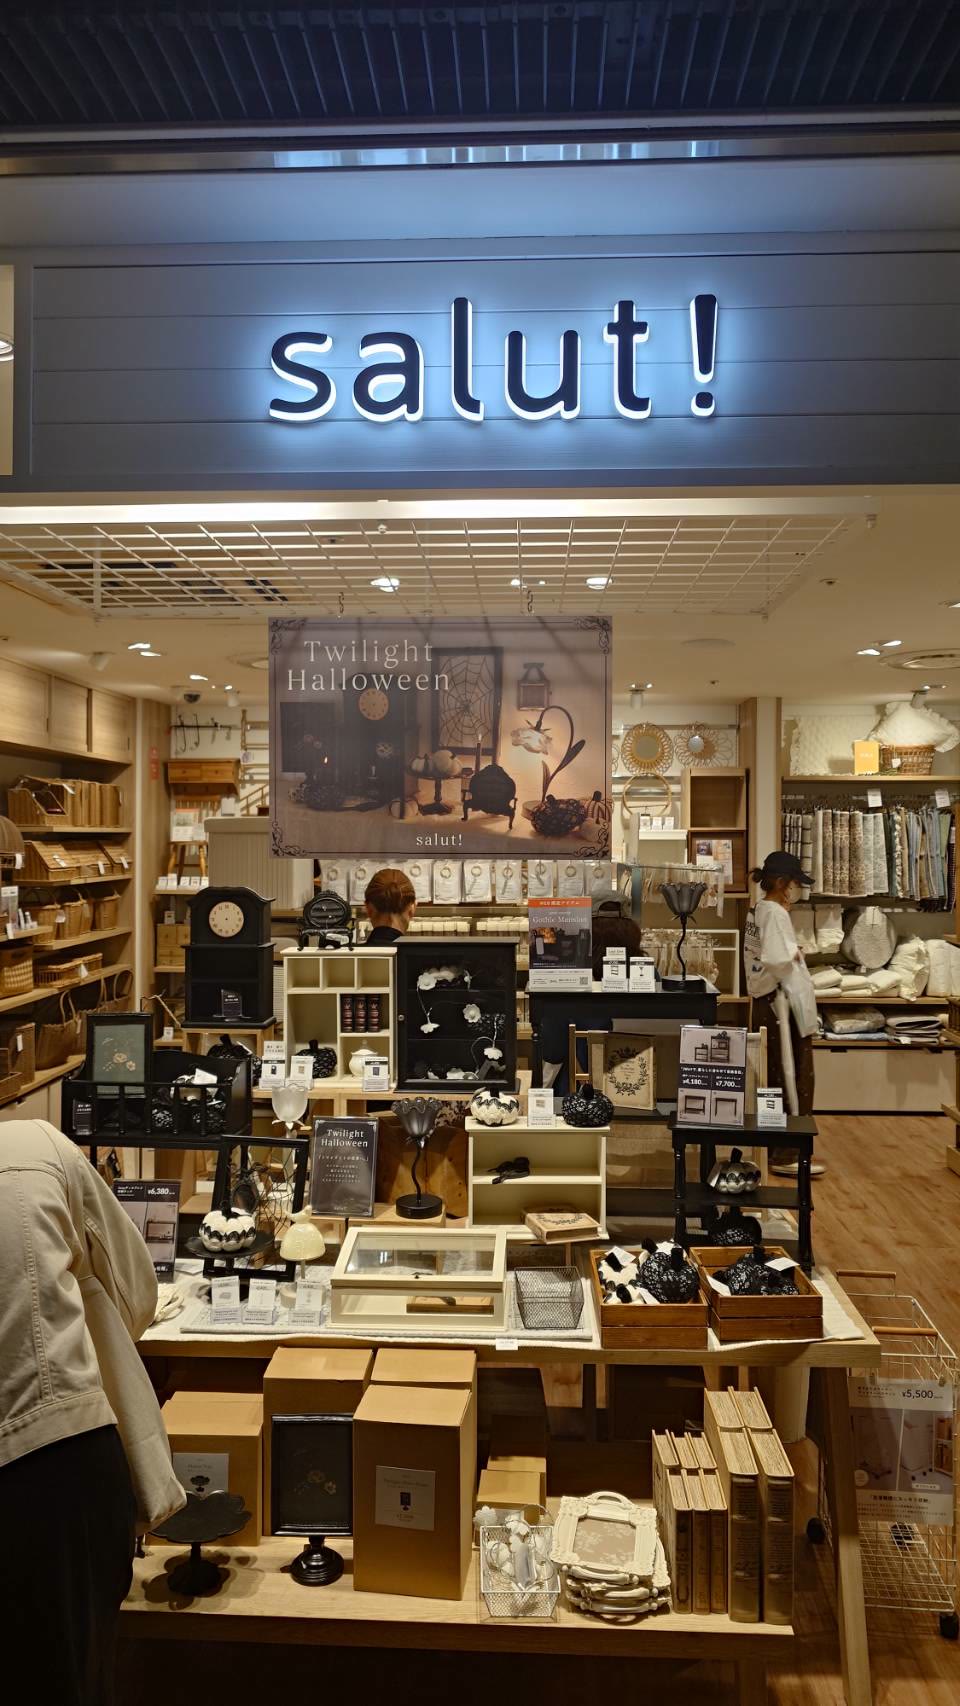
例如在天神看到 salut!,拍下招牌後就能查品牌特色與主要分店城市;抽到日文籤詩時,也能先翻譯內容,再說明不同項目的意思。

天神地下街的salut生活雜貨店
看到陌生品牌時,照片可以直接成為AI現場查詢的入口。
旅途中抽到的第九番吉籤
除了翻譯文字,也可以請AI依願望、旅行、健康等欄位分項說明。

但涉及食品入境、交通票適用範圍或醫療等高風險資訊,我仍會要求它查官方規定,不會只看包裝照片就下結論。

十、旅行結束後,別只留照片,要做一次 AI 復盤

一趟行程走完後,可以請 AI 比較「原計畫」與「實際發生」,把經驗寫回下一次的規劃規則:

請根據這次原始行程與實際紀錄,整理估時錯誤、成功備案、可省略景點、家庭偏好與下次應提前確認的事項。請將結果改寫成可重複使用的規則,不要寫成遊記。

像是大型商場需抓六至七小時、一天兩餐、屋台採彈性安排、跨城市交通後保留緩衝,都不是網路攻略能直接告訴我們的答案,而是旅行過一次後才得到的個人化資料。

AI 與人,最適合怎麼分工?

我目前的分工方式是:

  • AI 負責: 蒐集與整理資料、比較交通、檢查營業時間、維護試算表、產生晴雨備案、現場重排與事後復盤。
  • 人負責: 決定真正想去的地方、判斷家人體力與心情、完成付款與預約、查核高風險資訊,以及隨時推翻原計畫。

如果只把 AI 當成自動景點清單產生器,我大概不會給太高評價;但若先教它家庭習慣,再用固定格式持續更新,它就會變成很好用的旅行助理。

這次我會給 9 分(滿分 10 分)。雖然 LaLaport 估時不足、預約資訊曾判斷過快,跨城市行程的緩衝也還能加強,但整趟旅行因為有蝦蝦協助維護試算表、查詢現場資訊、處理雨天備案與交通延誤,確實方便而且順暢很多。少掉的 1 分不是否定 AI 的幫助,而是提醒我們:只要持續把實際經驗寫回規則,下一次還能排得更貼近一家人的步調。

所以「AI 排行程後,現場到底好不好用?」我的答案是:

好用,但前提不是要求它一次排出完美行程,而是把自己的旅行習慣說清楚、保留可刪減順序,並在每次旅行後繼續修正規則。

AI 不必比人更懂旅行;它只要越來越懂你們家怎麼旅行,就已經很有價值了。

2026年9月1日 星期二

我讓 AI 家庭管家規劃東京自由行:真正困難的不是排景點,而是把行程變得能走

這次東京自由行,我做了一個有點不一樣的實驗:把行程規劃交給 AI 家庭管家「蝦蝦」協助。

一開始我以為,這件事大概就是把想去的景點丟給 AI,再請它排成八天七夜。實際做下去才發現,列出一份看起來豐富的行程很簡單;真正困難的是讓它符合交通、營業時間、預約、體力和家人喜好,而且到了東京真的走得動。

這篇不只是分享東京景點,而是整理我們怎麼把一段普通的聊天,逐步變成可執行的行程表,以及過程中踩到哪些 AI 規劃旅遊常見的坑。

AI 龍蝦家庭管家與家人一起在東京地圖上規劃自由行
真正好用的 AI 行程,不只是列景點,而是一起比較交通、預約、體力與備案。

第一個問題:使用者說的是願望,不是規格

人在討論旅行時,通常不會一次交出完整需求。我們比較可能陸續說:想逛某間店、不要去 Disney、某天有預約、希望不要走太累,或突然又想到一個想吃的東西。

如果 AI 只處理最後一句話,很容易每改一次就破壞前面的安排。因此,我們先把零散對話整理成幾種不同限制:

  • 固定限制:旅遊日期、住宿位置、已購買的門票與預約時間。
  • 明確排除:例如這次不安排 Disney,就不能過幾輪又把它當成推薦景點塞回來。
  • 個人偏好:喜歡逛的店、可接受的步行量、購物與景點的優先順序。
  • 彈性項目:有時間才去,下雨或太累可以刪除。

這其實很像軟體開發的需求管理。景點清單只是 backlog,真正要做的是標示優先級、相依性和不可違反的條件。

第二個問題:地圖上同一區,不代表動線真的順

AI 很容易用「區域名稱」排路線,例如把上野、谷中、根津視為同一區,然後判定它們可以順路走完。但旅途中真正影響體力的,往往是住宿處到車站的距離、轉乘次數、出口位置,以及下車後還要走多久。

我們曾檢討谷根千的安排。若只看觀光分類,從根津開始逛似乎合理;實際核對後,住宿處前往千代田線並不方便,而且根津站走到谷中銀座也不算近。改成從上野搭 JR 到日暮里,再步行進谷中銀座,才比較符合「少走一點」的目標。

這讓我得到一個很重要的原則:

行程最佳化的單位不能只有景點,必須包含「住宿地 → 車站 → 轉乘 → 出口 → 步行」。

後來每段行程都盡量補上主交通方式、轉乘提醒、預估步行時間,也會一併評估東京地鐵票券是否真的划算。因為一張票涵蓋很多路線,不代表為了使用它而多轉車就是省錢。

第三個問題:預約景點不是表格裡的一列,而是硬性約束

一般景點可以前後移動,但已預約的展覽或觀景台不行。它們比較像排程系統裡不能錯過的 deadline。

例如某天下午 5 點有 DQ 特展預約,前面的購物與散步就必須保留緩衝時間;如果逛店超時,應該縮短中間停留,而不是讓整天行程一起往後滑。另一天晚上 6 點半有晴空塔門票,下午的六本木行程便要設定明確離場時間,而不能只寫「傍晚前往押上」。

更大的教訓則來自 teamLab Planets。最初雖然把它排進行程,卻沒有把「票券是否已購買」當成獨立狀態確認。到了當天買不到票,加上豐洲市場週日休市,只好臨場改成千客萬來與台場。

這次調整不算失敗,最後也順利看到台場獨角獸鋼彈的燈光;但它清楚暴露一個問題:

「已排入行程」不等於「已確認可執行」。

所以需要預約的地點至少要有「尚未確認、已訂票、已確認時間」等狀態,並在出發前再次檢查,而不是只出現在行程名稱裡。

第四個問題:好看的答案,不一定是好用的交付物

聊天視窗適合討論,但不適合在旅行當天快速查資料。我們最後把行程整理到 Google Sheet,而且不是把大段文字直接貼進去,而是慢慢調整成實際好讀的格式:

  • 同一天的日期合併顯示。
  • 時段緊接在日期後面。
  • 主交通方式獨立成欄。
  • 保留區域、地點、地址、備註、費用與成行狀態。
  • 使用換行、欄寬與置中,讓手機上也能快速掃到重點。

這裡也踩過一個很工程味的坑:試算表裡的空白列可能造成寫入列號偏移。因此,每次修改後不能只相信 API 回傳成功,還要重新讀取內容核對,並避免覆蓋原本已確認的行程。

換句話說,AI 行程規劃的最後一哩,不是生成文字,而是把內容寫進使用者真正會打開的工具,並驗證寫入結果。

幾個實際案例:同一句需求,講法不同會排出完全不同的行程

和龍蝦排行程時,我慢慢發現一件事:AI 不是不能排,而是它不知道我心裡哪一條條件最重要。如果我只丟景點名稱,它就只能猜;把取捨原則說清楚後,結果才會開始像「我的行程」。

案例一:不要只說「幫我排順路」

原本我可能會說:

幫我把谷中銀座、根津、上野排在同一天,要順路一點。

問題是「順路」有很多解釋。AI 可能理解成地圖上由南往北依序走,也可能單純把同區景點放一起,卻沒有計算從住宿地出發是否方便。

更有效的說法是:

我們從住宿處出發,希望少走路、少轉乘。請比較「根津開始」和「JR 日暮里開始」兩種走法,列出搭乘路線、轉乘次數、下車後步行時間,再推薦比較省力的方案。不要只因為景點在同一區就判定順路。

這種問法要求 AI 先比較方案,而不是直接生成一個看似合理的答案。最後我們也因此發現,從日暮里進谷中銀座,比特地轉進根津更符合當天需求。

案例二:加一個景點時,要說能不能犧牲原行程

旅行前很容易一直看到新景點,然後對 AI 說:「這個也幫我加進去。」如果沒有補充條件,AI 常會努力把它塞進空隙,結果每一站都只剩一點時間,交通也變得很趕。

更有效的說法是:

我想加入中野,但不要壓縮晚上 18:30 晴空塔的預約,也不要讓下午連續趕三個區域。請先判斷是否適合放進原行程;如果不適合,告訴我應該替換掉哪一站,不要硬塞。

關鍵是允許 AI 回答「放不下」。行程規劃不是俄羅斯方塊,空白也不是浪費;它可能是迷路、排隊、休息和臨時購物所需要的緩衝。

案例三:已預約和想去,必須用不同等級描述

「我想去晴空塔」與「我已買好 18:30 晴空塔門票」對排程的意義完全不同。前者可以移動或取消,後者是整天行程的錨點。

更有效的說法是:

7/27 晴空塔已購票,入場時間 18:30,這是不可移動行程。請從預計抵達時間往前倒推,包含找入口、排隊和至少 30 分鐘緩衝,告訴我六本木最晚幾點要離開。

這樣 AI 才會做「倒推排程」,而不是把兩個景點分別列在下午和晚上,卻沒有回答中間到底來不來得及。

案例四:票券狀態要明講,不能只說想去

teamLab Planets 的經驗最直接。把景點排進表格時,如果沒有說票還沒買,AI 很可能默認它是可執行的行程。

更有效的說法是:

teamLab Planets 想去但尚未購票。請標成「待確認」,查需要預約還是能現場買,並準備同區、不需要預約的雨天替代方案。在我確認買到票以前,不要把它當成固定行程。

這裡不是要 AI 保證一定有票,而是要求它把「願望」與「已完成準備」分開管理。若當天仍無票,也能快速切換到千客萬來或台場,而不是整段行程臨時重排。

案例五:告訴 AI 是誰要走這份行程

只說「步行不要太多」仍然很抽象。有人覺得一天兩萬步很正常,有人走一萬步就已經想回飯店躺平。

可以改成:

這是家庭旅行,請用「不趕路」為優先。連續步行超過 20 分鐘要提醒,每半天最多安排兩個主要區域;午餐保留 60~90 分鐘,晚上預約前至少留 30 分鐘緩衝。若行程超量,優先刪除購物以外的備選景點。

一旦把「累」轉成可檢查的規則,AI 才有辦法在新增景點時主動指出衝突。

🦞 跟龍蝦排行程的四句核心指令
① 先整理限制,不要急著排。
② 比較交通方案,不要只看同一區。
③ 放不下就提出替換,不要硬塞。
④ 修改指定區段,保留已確認內容。

如何更有效地和龍蝦一起排行程

實際使用後,我覺得最有效的方式不是一次下完美指令,而是分階段協作。每一階段只解一種問題,會比叫 AI 一次產生八天完整行程可靠很多。

第一步:先建立旅行規則,不急著排每天

先告訴 AI 這趟旅行的基本資料:

  • 日期、航班與住宿地區。
  • 同行者及體力需求。
  • 一定要去、想去、可有可無與明確不去的地點。
  • 已購票或已預約的日期時間。
  • 能接受的起床時間、步行量與每日景點密度。
  • 購物、美食、拍照、親子或動漫等偏好的優先順序。

可以直接這樣說:

先不要排每日行程。請把下面資料整理成「固定限制、偏好、排除項目、待確認事項」四類;有矛盾或資訊不足先列問題,不要自行猜測。

這一步很重要,因為它可以先抓出「同一天兩張不同區域的票」或「想去的店只在某幾天營業」等衝突。

第二步:先分區,再排時間

不要一開始就要求精確到每半小時。先讓 AI 依真實交通把景點分成幾組,並說明為什麼適合同一天。

可用的說法是:

請依住宿處出發的交通便利性分組,不要只看地理距離。每組列出主要車站、適合搭配的景點、最麻煩的轉乘,以及大約需要半天還是一天。

看過分組後,人再決定哪一組放哪一天。這比讓 AI 一次決定所有日期更容易檢查,也比較不會牽一髮動全身。

第三步:用固定行程當錨點,往前後排

先放入門票、展覽、餐廳訂位與只能特定日期去的店。接著從這些錨點往前後補行程。

這一天的固定錨點是 17:00 DQ 特展。請倒推最晚出發時間,前一站安排可隨時離開的地點;15:30 後不要再加入需要排隊或至少停留一小時的景點。

這能避免 AI 把高不確定性的活動排在預約前面。逛街通常可以提早離開,主題展或熱門餐廳則不一定。

第四步:要求它揭露假設與風險

AI 給出行程後,不要只問「這樣可以嗎」,而要請它主動找碴:

請用挑錯模式檢查這一天:營業日、最後入場、是否需預約、交通轉乘、步行過長、用餐時間、行李與回飯店路線。把不確定資訊標出來源與查詢日期,不確定就說不確定。

這個步驟可以把漂亮的行程文案,轉成比較接近上線前測試的結果。尤其日本店家臨時休業、展覽預約制與市場休市,都不能只靠模型記憶判斷。

第五步:修改時說清楚「只改哪裡」

若只說「幫我調整一下」,AI 可能順手重排整天,連已確認的內容都改掉。比較安全的講法是:

只修改 7/28 下午,上午吉祥寺與晚餐保持不變。把中野加入後重新計算交通;若時間不足,谷中銀座改成備選。不要更動其他日期。

這就像修改程式時限制變更範圍,可以降低回歸錯誤,也讓人更容易比較調整前後差異。

第六步:要求輸出「主方案、刪減點、備案」

真正好用的行程不只一條路。每一天最好同時準備:

  • 主方案:天氣與體力正常時照著走。
  • 優先刪減點:落後 30~60 分鐘時先取消什麼。
  • 雨天或無票備案:不要跨太遠,最好在同一區。
  • 返回方案:太累時從哪個車站最方便回住宿處。

可以這樣要求:

請不要把備案混進主時間表。主方案照順序列出,另外標記「延誤 30 分鐘先刪哪站」和「下雨時換去哪裡」,讓我現場不用重新問一次。

第七步:出發前做一次整體凍結與核對

行程接近完成後,應該把已確認內容凍結,不再每天因為新推薦而大改。最後一次請 AI 檢查:

這是出發前定稿。請列出所有尚未購票、需要再次確認營業時間、交通仍有疑問的項目;不要再推薦新景點。確認完成後,把結果同步到行程表,並讀回核對是否寫入正確。

「不要再推薦新景點」其實很重要,否則 AI 永遠能再找到十個值得去的地方,行程也永遠不會完成。

一份可以直接複製使用的行程規劃指令

如果要快速開始,可以把下面這段交給 AI,再逐步補資料:

你是我的自由行規劃助手。先不要急著產生完整行程,也不要自行補上我沒說過的偏好。請先把資料整理成:固定限制、已預約/已購票、一定要去、想去、可刪除備選、明確不去、待確認事項。

排程時以實際交通與步行負擔為準,不要只因景點在同一區就視為順路。每一天先放不可移動的行程,再往前後安排;預約前保留至少 30 分鐘緩衝。新增景點時若時間不足,請提出替換方案,不要硬塞。

每段請列主要交通、轉乘、車站出口、預估步行和停留時間。需要預約、可能休館或資訊不確定的項目要明確標示,不可假設已經買到票。

每天提供主方案、優先刪減點、雨天/無票備案,以及太累時的返回方式。修改時只調整我指定的日期與區段,保留其他已確認內容。最後輸出前請做一次風險檢查,並列出仍需由我確認的事項。

這份指令不是用來一次得到完美答案,而是建立雙方共同遵守的規則。之後每次新增資料,龍蝦就能用同一套標準判斷,而不是從頭猜一次。

我們最後形成的規劃流程

經過幾輪修改後,整套流程大致變成:

  1. 收集想去的景點、餐廳、購物點與排除項目。
  2. 標記不可移動的預約與尚未購票的風險。
  3. 依住宿位置與實際交通,而不是只看行政區域來分組。
  4. 計算轉乘、出口與步行成本,保留休息及緩衝時間。
  5. 將次要景點設成可刪除的彈性選項。
  6. 寫入 Google Sheet,讀回核對格式與內容。
  7. 旅行途中依天氣、體力、營業狀態與票券即時調整。

從技術角度看,這比較接近「帶狀態的反覆規劃」,而不是一次性的文字生成。AI 不只要會推薦景點,還必須記住已確認的決策、辨識限制衝突,並在新資訊出現時只調整受影響的部分。

AI 做得好的地方,以及人仍然要把關的地方

AI 很適合做大量整理:把散落在對話裡的需求結構化、比較多種動線、補齊交通欄位,或在臨時取消景點時快速產生替代方案。它也很適合維護表格,減少人工反覆搬資料的時間。

但幾件事情仍不能完全放手:

  • 營業日、臨時休館與最新票況要查官方來源。
  • 地圖上的時間只是估算,還要考慮找路、等車與家人的步調。
  • AI 可能忘記先前已排除的選項,因此關鍵決策要持續保存。
  • 修改外部文件後必須讀回驗證,不能把「送出成功」當成「內容正確」。

最理想的分工不是讓 AI 決定所有事情,而是讓它負責高成本的整理與比較,人負責偏好、取捨和最後確認。

結語:旅行規劃其實是一個小型系統工程

這次經驗讓我覺得,AI 規劃自由行真正有趣的地方,不是它能在幾秒內列出十大景點,而是它能不能在持續變動的需求中,維護一份真的能執行的計畫。

一趟家庭旅行同時包含需求訪談、限制條件、路線最佳化、資料驗證、例外處理與介面設計。說穿了,根本就是一個小型系統工程,只是最後部署的不是程式,而是我們一家人在東京的一天。

而最實用的成果也不是一份排得滿滿的完美行程,而是一份知道什麼不能錯過、什麼可以臨時放掉,遇到變化仍然走得下去的計畫。

2026年4月21日 星期二

為什麼 OpenClaw 排程一直送不出訊息?一次追到 LINE 429 的原因


最近我排查了一個很典型的通知系統問題。

表面上看,OpenClaw 的排程有正常執行,網站資料也抓得到,但 LINE 群組始終收不到通知。更容易誤導的是,部分 run 還顯示 ok,讓人一開始直覺懷疑是網站解析、排程設定,或 prompt 寫法出了問題。

但一路拆解之後,最後真正的根因不是 cron,也不是解析流程,而是 LINE 官方帳號本月免費訊息額度用完,導致主動發送持續被 429 擋下來。

這篇整理成一篇偏技術部落格風格的精簡版記錄,聚焦在排查順序、關鍵判斷點,以及最後如何收斂到真正的根因。


問題現象

當時的需求很單純:

  • 定時執行 OpenClaw cron
  • 檢查某個公告頁面
  • 若有新公告,就主動發送到 LINE 群組

實際看到的症狀是:

  • cron 有跑
  • 群組沒收到訊息
  • 部分 run 顯示 ok
  • 部分 run 出現:
  • HTTPFetchError: 400 -
  • HTTPFetchError: 429 -
  • deliveryStatus: not-delivered

這類問題最麻煩的地方在於,系統看起來像只有一個問題,實際上往往是多層故障疊在一起。


第一步,先修排程邏輯,而不是先猜平台壞掉

這次最先修的不是 LINE,而是排程本身的送訊邏輯。

當時的設計同時存在:

  • 任務內自己嘗試送訊
  • 外層 delivery/announce 機制也可能介入

這會產生一個典型問題:

  • 任務內若沒有真的送成功,只是輸出「原本應該送什麼」
  • 外層又可能把這段內容當成待送摘要處理

結果就會變成:

  • 看起來像有處理內容
  • 但其實沒有真正送出
  • 還可能多製造一層錯誤

所以第一個修正方向,是把送訊責任收斂成單一來源,避免任務內邏輯和外層 delivery 機制互撞。


第二步,先保證資料一致性

下一步不是硬把通知送出去,而是先修正這件事:

送訊失敗時,不能把資料誤記成已送。

因此我重寫了排程 prompt,核心原則是:

1. 有新公告才處理

2. 只有確認送出成功後,才更新正式已送記錄

3. 如果送訊失敗或不確定是否送達:

  • NO_REPLY
  • 不更新記錄檔
  • 不輸出「應送內容」摘要

這一步很重要,因為它把問題先從「可能污染資料」縮小成「純粹的發送失敗」。

後來做受控測試也確認:

  • 即使 LINE 發送失敗
  • 正式記錄檔也不會被誤回寫

這代表資料一致性已經被保住。


第三步,確認問題不是「沒送」,而是「送了但失敗」

一開始最容易誤判的地方是:

  • run 顯示 ok
  • 但群組沒收到訊息

這時候至少有兩種可能:

1. 任務根本沒送

2. 任務有送,但送失敗後被正確處理掉了

後來直接看 transcript 才確定:

  • 任務內確實有嘗試送 LINE
  • 但送訊時碰到 429
  • 然後依規則 NO_REPLY
  • 所以 run 還是可能顯示 ok

這一步很關鍵,因為它把問題收斂成:

cron 執行流程沒壞,真正失敗的是 LINE 發送端。


第四步,從 log 看出這不是單一 job 問題

接著去看 gateway log,很快就發現不是只有某一支 cron 在失敗,而是整條 LINE 通道近期都反覆出現:

  • line final reply failed: HTTPFetchError: 429
  • delivery-recovery: Retry failed for delivery ...: 429 -

這代表問題已經不能只看成單一排程故障,而要往更外層想:

  • 是不是 LINE channel 本身有問題?
  • 是不是平台在限流?
  • 是不是有 backlog 不斷重試?

第五步,找到 delivery backlog 的實體位置

後來我把 backlog 的實體位置挖出來了:

  • ~/.openclaw/delivery-queue/

裡面會留下待送但未成功的 delivery 項目,內容包含:

  • 舊通知
  • 測試訊息
  • 失敗通知

再結合 log 可以看出:

  • 某批 pending delivery 會被 delivery recovery 拿出來重試
  • 重試又再次碰到 429
  • 於是 queue 一直堆著、一直重試

這說明 backlog 的確存在,而且是跨時間持續存在。


第六步,隔離 backlog,但問題仍然存在

為了驗證 backlog 是否為主因,我採用比較保守的方式處理:

  • 停 gateway
  • 把 active queue 裡的 backlog 隔離到 quarantine 資料夾
  • 再啟動 gateway
  • 重新測試直接送訊

這種處理方式的好處是:

  • 不直接刪資料
  • 可回復
  • 能快速驗證 backlog 是否造成主要影響

但測完後結果很清楚:

  • backlog 確實被隔離了
  • queue 也乾淨很多
  • 但新的直接送訊仍然回 429

這表示 backlog 不是唯一問題,真正更底層的限制還在。


最後根因,LINE 免費訊息額度已用完

最後到 LINE Developers / 官方帳號後台確認,答案就很明確了:

  • 本月免費訊息額度已經用完

這時整個事件才完整串起來:

1. 主動發送額度先耗盡

2. 所有新的主動送訊都回 429

3. 送失敗的內容堆進 delivery queue

4. recovery 不斷補送

5. 補送再度 429

6. 表面上看起來像 cron 有跑但訊息永遠送不到

所以最後真正的根因不是:

  • cron 壞了
  • 網站解析壞了
  • OpenClaw 不會送 LINE

而是:

LINE 官方帳號的主動發送額度先耗盡了。


這次最值得保留的排查方法

這次事件裡,我自己覺得最值得保留的是下面這幾個排查習慣。

1. 不要把所有症狀都叫做「排程失敗」

要拆開看:

  • cron 有沒有跑
  • 任務邏輯有沒有走到送訊
  • delivery 狀態是不是 not-delivered
  • gateway log 在報什麼
  • backlog 有沒有持續重試
  • 平台本身是不是有限流或額度問題

2. 先修資料一致性,再修通知能力

先保證「失敗不會誤標成已送」,再處理送訊本身,這樣排查才不會把資料一起搞亂。

3. ok 不等於真的送到

這次最迷惑人的點就在這裡。run status 只能代表任務流程是否成功收尾,不能單獨代表通知真的送達。

4. backlog 一定要找實體位置

只看 log 很容易一直猜。真的找到 queue 檔案位置後,整個問題才變得可驗證、可操作。


遇到類似問題時的排查順序

如果你也遇到「排程有跑,但通知沒到」的問題,我會建議照這個順序查:

1. 確認 cron 是否真的有執行

2. 確認任務是否真的走到送訊邏輯

3. 確認失敗時不會誤回寫 sent 記錄

4. 查看 gateway log 裡的 delivery / 429 / 400 訊號

5. 檢查 delivery queue 是否有 backlog

6. 如果 backlog 清掉後仍然 429,就直接查平台額度或限流

這樣可以避免你一直在本地系統裡打轉,卻忽略真正的上游限制。


最後怎麼處理?

既然已確認這個月免費訊息額度用完,那在不付費前提下,最實際的作法不是硬送,而是:

  • 暫停主動 LINE 發送
  • 排程改成只記錄待通知內容
  • 同時輸出:
  • 一份人類好讀的 Markdown 待通知檔
  • 一份結構化 JSON 待通知檔
  • 等下個月額度重置後,再切回主動推播

這樣做的好處是:

  • 不再持續撞 429
  • 不再製造新的 delivery backlog
  • 不會遺失新公告資訊
  • 下個月可以平順恢復

結語

這次的問題很適合提醒自己一件事:

排程有跑,不代表通知真的有送到。

很多時候,問題根本不在 cron,而是在更外層的 delivery 設計、queue 重試機制,甚至平台額度本身。

如果我只停在「cron 顯示 ok」這一層,就永遠找不到真正原因。

這次最後能收斂到 LINE 免費額度用盡,靠的不是單一招,而是一路把每一層拆開來看,最後才把問題釘死。

如果你也在做 OpenClaw、LINE 通知、或任何有 queue / retry / 平台額度限制的系統,我很推薦保留這種排查思路。下次再遇到類似問題,會快非常多。

2026年4月1日 星期三

OpenClaw 串接 LINE Bot 後,加入群組卻無法回應?一次完整排查與修正紀錄

最近我把 OpenClaw 串接到 LINE,並把 bot 加入群組,原本以為只要加入成功,就能直接在群組中互動。結果實際測試後卻發現:


- 私訊 bot 沒問題

- bot 也確實已加入群組

- 但在群組裡呼叫它,卻完全沒有反應


這篇文章整理我這次的排查過程,希望能幫助遇到相同問題的人少走一些彎路。


問題現象

這次遇到的情況很明確:

- 私訊 bot 時可以正常回覆

- bot 已被加入 LINE 群組

- 但在群組裡傳送訊息,例如:

  蝦蝦 在嗎

  蝦蝦 回 1


bot 都沒有反應。


第一步:先確認是不是整體壞掉


我先直接私訊 bot 測試,確認:


- LINE channel 沒壞

- OpenClaw gateway 有正常運作

- bot 本身不是離線

- webhook 至少對私訊事件是正常的


結果是:私訊正常


這代表問題不是整體服務故障,而是更可能集中在群組路徑。


第二步:檢查 OpenClaw 狀態

接著查看 OpenClaw 與 gateway 狀態:

openclaw status --deep

openclaw gateway status


檢查後確認:


- OpenClaw 正常

- gateway 正常

- LINE provider 有啟動


所以可以先排除整個系統掛掉的可能。


第三步:檢查 openclaw.json

接著查看設定檔,找到 LINE 相關設定:


"channels": {

  "line": {

    "enabled": true,

    "dmPolicy": "pairing",

    "groupPolicy": "allowlist"

  }

}


這裡的重點是:

- 私訊使用 pairing

- 群組使用 allowlist

也就是說,群組不是自動允許,而是需要符合 allowlist 規則。


第四步:檢查 allowlist

進一步檢查後發現,目前 allow 清單裡只有使用者本人的 LINE ID,沒有群組 ID。

這代表:

即使 bot 已經加入群組,只要該群組 ID 沒有進 allowlist,群組訊息就可能被擋住。


第五步:嘗試查群組 ID

我接著用 OpenClaw 指令查詢群組:

openclaw directory groups list --channel line --account default --json

結果回傳是空的:

[]

這表示當下沒有成功取得群組 ID,也因此無法直接把該群組加入 allowlist。


第六步:回頭檢查 LINE 設定

接著回頭確認 LINE Developers / Official Account 的幾個重點:

- Use webhook 是否開啟

- Webhook URL 是否正確

- Verify 是否成功

- 是否允許 bot 加入群組 / 多人聊天室

- 是否使用正確的 Messaging API channel

確認後,這些設定都沒有問題。


第七步:先把 groupPolicy 改成 open

因為當下無法取得 group ID,所以先做一個最小調整,把:

groupPolicy = allowlist

改成:

groupPolicy = open

這一步的目的,是先排除 allowlist 的限制,驗證群組是否能正常工作。


第八步:設定改完後要重啟 gateway

修改設定後,日誌裡出現提示:

Updated channels.line.groupPolicy. Restart the gateway to apply.

這表示設定雖然已經寫入檔案,但還沒有真正生效。

所以如果只改設定、不重啟 gateway,接下來的測試可能還是在測舊設定。


第九步:重啟 gateway

最後執行:

openclaw gateway restart

重啟後再確認:

- gateway 正常 running

- LINE provider 已重新啟動

- 新設定已套用

到這裡,群組設定的變更才算真正生效。


這次排查學到的事


1. 私訊正常,不代表群組一定正常

私訊與群組是不同路徑,私訊可用只能證明 bot 沒整體故障。


2. allowlist 很容易成為盲點

bot 看起來在群組裡,不代表該群組真的被允許觸發回應。


3. 改完設定不代表已生效

有些設定需要重啟 gateway 才會真正套用。


4. 排查要一層一層拆

這次最有效的順序是:

- 先測私訊

- 再看 OpenClaw 狀態

- 再檢查 groupPolicy

- 再看 allowlist

- 最後重啟 gateway


建議的排查順序

如果你也遇到 LINE 群組裡 bot 不回應的問題,可以照這個順序檢查:


1. 私訊 bot,確認私訊是否正常

2. 執行 openclaw status --deep

3. 執行 openclaw gateway status

4. 檢查 openclaw.json 裡的 groupPolicy

5. 確認 allowlist 是否包含群組 ID

6. 執行 openclaw directory groups list --channel line --account default --json

7. 修改設定後記得重啟 gateway


結語


這次問題表面上看起來像是 LINE 群組訊息沒進來,但實際排查後發現,真正的關鍵在於:

- groupPolicy 使用 allowlist

- allowlist 裡沒有群組 ID

- 設定修改後還需要重啟 gateway 才會生效


如果你也在用 OpenClaw 串接 LINE,建議不要只檢查 webhook,

groupPolicy、allowlist 和 gateway restart 這幾個地方也一定要一起看。

2013年3月22日 星期五

How to Find a Yum Package

當要安裝一套library,可能不只要安裝64 bits版本,也需要安裝32 bits版本時,這個功能就很重要,可以查一下這套library的每種版本的名稱,以方便安裝。譬如說要安裝MyQL;

[root@]#yum search mysql

Loaded plugins: fastestmirror, security
Loading mirror speeds from cached hostfile
 * base: mirror01.idc.hinet.net
 * extras: mirror01.idc.hinet.net
 * updates: ftp.riken.jp
=========================================== N/S Matched: mysql ===========================================
MySQL-python.x86_64 : An interface to MySQL
apr-util-mysql.x86_64 : APR utility library MySQL DBD driver
bacula-director-mysql.x86_64 : Bacula Director with MySQL database support
bacula-storage-mysql.x86_64 : MySQL Bacula storage daemon files
dovecot-mysql.x86_64 : MySQL back end for dovecot
freeradius-mysql.x86_64 : MySQL support for freeradius
libdbi-dbd-mysql.x86_64 : MySQL plugin for libdbi
mod_auth_mysql.x86_64 : Basic authentication for the Apache web server using a MySQL database
mysql.x86_64 : MySQL client programs and shared libraries
mysql-bench.x86_64 : MySQL benchmark scripts and data
mysql-connector-java.noarch : Official JDBC driver for MySQL
mysql-connector-odbc.x86_64 : ODBC driver for MySQL
mysql-devel.i686 : Files for development of MySQL applications
mysql-devel.x86_64 : Files for development of MySQL applications
mysql-embedded.i686 : MySQL as an embeddable library
mysql-embedded.x86_64 : MySQL as an embeddable library
mysql-embedded-devel.i686 : Development files for MySQL as an embeddable library
mysql-embedded-devel.x86_64 : Development files for MySQL as an embeddable library
mysql-libs.i686 : The shared libraries required for MySQL clients
mysql-libs.x86_64 : The shared libraries required for MySQL clients
mysql-server.x86_64 : The MySQL server and related files
mysql-test.x86_64 : The test suite distributed with MySQL
perl-DBD-MySQL.x86_64 : A MySQL interface for perl
php-mysql.x86_64 : A module for PHP applications that use MySQL databases
qt-mysql.i686 : MySQL driver for Qt's SQL classes
qt-mysql.x86_64 : MySQL driver for Qt's SQL classes
qt3-MySQL.i686 : MySQL drivers for Qt 3's SQL classes
qt3-MySQL.x86_64 : MySQL drivers for Qt 3's SQL classes
rsyslog-mysql.x86_64 : MySQL support for rsyslog

  Name and summary matches only, use "search all" for everything.

就可以獲得完整的資訊,接下來就可以選擇要安裝的版本啦!!!!

[root@]#yum -y install mysql-libs.i686

跨平台C++程式小筆記

  1. 具備前後關係的container,會傳回下一個有效的iterator
    std::vector
    std::deque
    std::list
    請用 i = abc.erase(i);

    不具備前後關係的container,則透過post operator來處理
    std::map
    std:multimap
    std::set
    std:: multiset
    abc.erase(i++);

    參考網址
    http://stackoverflow.com/questions/433164/what-happens-to-an-stl-iterator-after-erasing-it-in-vs-unix-linux
  2. 盡可能的專案底下的*.cpp與*.h檔案,必須與.vcproj 檔案放在同一層,範例如下。

    D:\Project\aaa.vcproj
    D:\Project\aaa.h
    D:\Project\aaa.cpp

    不要再多一層目錄來存放*.h與*.cpp。
  3. gcc的compiler不認識將字串轉成寬字元的前導字元L,所以各位如何有需要將中文字寫進程式碼內的需求的話,請使用讀檔的方式。

    wchar_t wc = L’我 ’; è error!!!!

CentOS 6.x上面安裝gcc 4.7

因為我的C++程式需要用到較新的gcc版本,所以就來研究一下怎麼從無到有的來安裝gcc4.7;雖然官方都有提供下載路徑,但是重點在於configure的設定,經過一番測試,只需要依序執行以下的指令,gcc 4.7就從下載到建置到安裝一口氣完成,缺點是必須要等待你的機器做完這些事情,反正是新裝機嘛~~就讓它跑一下吧!!!

64位元版
yum -y install glibc-devel.i686 glibc-devel
sudo yum install glibc-static libstdc++-static
wget http://ftp.gnu.org/gnu/gcc/gcc-4.7.0/gcc-4.7.0.tar.gz
tar xzf gcc-4.7.0.tar.gz
cd gcc-4.7.0
./contrib/download_prerequisites
cd ..
mkdir build_gcc4.7
cd build_gcc4.7
../gcc-4.7.0/configure --prefix=$HOME/.local --enable-languages=c,c++ --disable-multilib --enable-checking=release --enable-bootstrap  --build=x86-centos-linux 
make -j4
make install

32位元版
yum -y install glibc-devel.i686 glibc-devel
sudo yum install glibc-static libstdc++-static
wget http://ftp.gnu.org/gnu/gcc/gcc-4.7.0/gcc-4.7.0.tar.gz
tar xzf gcc-4.7.0.tar.gz 
cd gcc-4.7.0 
./contrib/download_prerequisites 
cd .. 
mkdir build_gcc4.7
cd build_gcc4.7
../gcc-4.7.0/configure --prefix=$HOME/.local --enable-languages=c,c++ --disable-multilib --enable-checking=release --enable-bootstrap --host=i686-linux-gnu --build=i686-linux-gnu
make -j4
make install

2013年3月7日 星期四

DOS指令 不需要寫死路徑

DOS指令 不需要寫死路徑

REM %CD%意指目前目錄
echo %CD%
REM %~dp0意指目前BATCH檔案的目錄
echo Script dir = %~dp0
REM %0意指目前BATCH檔案的目錄及檔名
echo Batch path = %0
REM %1意指目前的引數
echo User argument 1 = %1
Set ScriptDir=%~dp0
REM /D代表切換到那個磁碟機的目錄
CD /D %ScriptDir%

2012年3月6日 星期二

遊戲產品專案開發(三)

伍、 專案成立後的人員職掌與權責分配
一、 專案成立的人員構成流程
成立一個專案,其實我們也可以想像如同成立一家公司一樣,當成立一家公司時,最重要需要構成的人員是誰,我想答案應該很清楚了,就是這家公司的負責人,也就是董事長,對應到遊戲專案身上時,那就是所謂的遊戲製作人(Producer),接下來呢?應該八成以上的答案會是總經理吧!沒錯,接下來要構成的人員就是可以充分組織公司成員及規劃公司方向的總經理,而總經理對應到遊戲專案是誰呢?他就是所謂的遊戲監製(Director),在成立一個遊戲專案時,最優先構成的人員就是製作人(Producer)與監製(Director)。
當董事長與總經理都出現了之後,接下來需要構成的就是成為這家公司主幹的主管們了吧!所以在遊戲專案中,接下來需要構成的人員為各個專業領域的Leader,遊戲專案一般都區分為三個專業領域,分別是企劃(Game Designer)、程式(Programmer)以及美術(Artist)三個部份,所以接下來需要構成的成員必須是能夠幫助監製(Director)穩定這三個領域的資深人員,在一般的情況下,監製都可以去勝任企劃領域的工作,所以很有可能只需要再構成程式及美術專業人員即可,但是要視專案而定,沒有絕對的方式。
接下來就是組成公司員工的部份,一般狀態下會由主管來面試,總經理來進行複試,遊戲專案的道理也是相同,只是因為一般來說,開公司是想要越開越久的,但是執行專案確希望越短越好,所以在人才的掌握度上,甚至會完全交由製作人(Producer)來掌握,因為再怎麼說製作人(Producer)也是這個專案的Leader,對於專案的成敗是必須負完全的責任,所以人員的篩選是一點也不得馬虎的事,但是一但被決定了參與人員,製作人(Producer)也要有本事將專案導向完成的狀態,否則在該進行判斷與決定時,製作人(Producer)也必須做出相對應的判斷,到了這個階段,成員算是齊了,專案也應該正式運行中。
二、 專案人員的職掌與權責
專案成立之後,為了運作的順暢,也必須要有如果公司組織一樣的指揮體系,讓命令及工作能夠貫徹,一般常用的專案成立之後的組織架構與職掌分配如下圖:
上圖是一般遊戲專案常用的組織及職掌規劃,這是基本的架構,也可以因為實際人員的能力與現況來進行調整,一般常用的調整是將Director與Leader結合,但是仍然需要依據專案的需求來調整。接下來先就上圖為基礎,每個成員需要負責的內容與職責進行說明:
1. 製作人(Producer)
整個專案的負責人,負起專案成敗的責任,必須要非常清楚這個遊戲產品最後的成像,且販賣時的景像也要非常清楚,在專案開始之前擬定BP(Business Plan)並帶領團隊去執行,帶領整個專案的成員成功的執行完產品並銷售的關鍵人物。如果要描述製作人在專案中負責的工作,可以整理如下:
I. 製作Business Plan。
II. 預估成本與預估獲利。
III. 給予產品明確方向與定位。
IV. 帶領專案成員成功完成專案,掌控專案執行成本。
V. 適時的判斷專案執行風險與修改Business Plan。
VI. 主導擬定行銷、宣傳計劃。
VII. 裁定與決定專案執行時的爭執。
VIII.產品販售後的市場資料收集。
2. 監製\監督\導演(Director)
整個遊戲產品製作內容的決定者,必須是對這個產品有極度的自信,也必須非常清楚產品完成後的樣子,掌控整個遊戲的設計與創意,負責整個遊戲產品的品質與內容。監製在專案內的工作可以整理如下:
I. 掌握整個專案的規模與內容。
II. 掌控整個遊戲產品的品質。
III. 掌握所有專案成員的製作Schedule。
IV. 篩選所有的創意與設計。
V. 非常明確的給予成員設計方向與製作內容。
VI. 協助完成GDD(Game Design Document),如果沒有主企劃的情況下,則為主導。
3. 美術監製(Art Director)
掌握整個遊戲產品的美術風格與視覺感受,所有跟視覺有關的都是他的管轄範圍,包含動畫、特效、模型等等,一手包辦掌握所有要進入遊戲的美術資料。美術監製在專案內的工作可以整理如下:
I. 決定遊戲產品的美術風格與執行作法。
II. 調整遊戲中的視覺設計的平衡。
III. 管理所有的美術外包資料。
IV. 確定所有美術資料的產出流程。
4. 技術監製(Technical Director)
整個專案內技術的先驅,藉由深厚的技術與老練的經驗,可以幫助專案解決技術層面的各種問題,達到更有效率的開發專案的效果。技術監製在專案內的工作可以整理如下:
I. 技術指導與技術突破。
II. 主導完成軟體開發架構。
III. 協助完成TDD(Technical Design Document) 如果沒有主程式的情況下,則為主導。
5. 主程式(Lead Programmer)
專案內程式人員的組長,管理所有程式人員的工作內容,完全是管理者的角色,但是本身也必須投入製作的行列,主程式在專案內的工作可以整理如下:
I. 主導完成TDD(Technical Design Document)。
II. 工作分配與管理。
III. 程式功能製作。
6. 主企劃(Lead Planer)
專案內企劃人員的組長,管理所有企劃人員的工作內容,完全是管理者的角色,但是本身也必須投入製作的行列,主程式在專案內的工作可以整理如下:
I. 主導完成GDD(Game Design Document)。
II. 工作分配與管理。
III. 遊戲內容設計。
7. 主美術(Lead Artist)
專案內美術人員的組長,管理所有美術人員的工作內容,完全是管理者的角色,但是本身也必須投入製作的行列,主程式在專案內的工作可以整理如下:
I. 主導完成概念圖。
II. 工作分配與管理。
III. 美術元件製作。
8. 程式(Programmer)
組成專案內程式領域的基本成員,負責執行被安排的程式方面的工作。
9. 企劃(Game Designer)
組成專案內企劃領域的基本成員,負責執行被安排的程式方面的工作。
10. 美術(Artist)
組成專案內美術領域的基本成員,負責執行被安排的程式方面的工作。
上面提到的是一般常用的分配方式,在因應功能執行的前提下,有些專案的組成會以下面的方式來構成,這就是偏向功能導向的分配方式:
這個方式與上面提到方式最大的不同點是完全以功能導向來管理,並非專業導向的方式,這個架構最大的魅力是可以培養出儲備的管理者,養成每個企劃人員都有專案管理的能力與基礎,也較能立即充分掌握實際製作時的效果,原本是各個專業領域的管理者則由企劃人員取代,所有企劃則納入監製的管轄,監製與製作人的關係依然沒變,變的只是實際製作的指揮與管理體系。
其實專案的指揮架構完全取決於製作人,很有可能因為專案的規模來適時調整指揮的架構,只是這些制度最好能在專案執行前就先說明清楚彼此間的權責劃分,以免專案製作過程中綁手綁腳互相推卸責任,明訂清楚後事後的檢討也才會有意義,否則將會成為羅生門,成為一樁懸案,這樣對製作人員的成長與公司的成長都是沒有幫助的。
陸、 專案開發各階段詳細說明
一、 創意發想
1. 創意發想的技巧
創意發想的方式有很多種,最重要的是要去找出樂趣再哪裡,當發現有趣的東西時,去追問為什麼有趣,不斷的追問下去,追問到底,透過這樣的分析法,可以去發現樂趣的根源在哪兒,而且試著用誇張的言語來表達,除了遊戲之外,也可以從其他娛樂產業來尋找有趣的點,像電影、漫畫等等,儘可能的去想出很多有趣的點子再來進行篩選。
2. 創意發想需要注意的地方
一開始在發想時,不要自我受限,如果有感覺到是有趣的東西時,表示那就是有趣的,是一件事實不需要去懷疑的,但是如果原來會覺得有趣的東西,經過分析之後覺得不有趣了,很有可能是分析不夠完整的問題,可以去思考是否哪裡漏掉了,也可以從別人的質疑來獲得提示;如果別人質疑有趣的點時,換個角度思考,可能有趣的點是在別的地方,而不是現在分析的這個點,而且最後會發現一個有趣的現象,其實人類的思考是很接近的,大家會覺得有趣的點其實都差不多。
有些有趣的點可能只適合向電影或電視這種用單向式(被動式)傳達表現的方式使用,在遊戲中想要表現出可憐、悲傷這些情感是很難的,因為遊戲是屬於主動式的傳達方式,所以玩家很有可能自己去迴避掉可憐、悲傷的情節,這也是要認清傳達的表現方式的可能性,去引起人類的情緒是娛樂產業的重點。
3. 產生遊戲概念(Game Concept)
在累積非常多的創意之後,必須要進行篩選,必須要進行主題的挑選,這是為了完成遊戲概念必要的功課,要凝聚出一個主要的核心概念,否則就跟聊天打屁沒什麼二樣了,可是有時候核心的概念並不是說出來就出來的東西,可能是必須要堆積了很多創意,才會自然而然的產生出來,總之,將創意的想法寫進遊戲概念的文件中反覆閱讀,看是否還缺了什麼,還有哪裡不夠,慢慢把東西凝聚出來,完成遊戲概念,接下來就可以開始進行企劃書的製作。
二、 產生企劃書(Creative Plan)
在要產生企劃書的階段,如果已經有遊戲概念將會是非常方便的,這樣說好像也是可以沒有遊戲概念就進行企劃書的製作,其實是可以的,經驗足夠的企劃或許不需要經過遊戲概念的產生,直接進行企劃書的製作,腦袋必須要很清楚遊戲的內容,這樣寫出來的東西才不會言不及意或是不合邏輯。
完成後的企劃書就可以讓製作人來進行審閱,如果製作人發現這份企劃書非常的具有潛力與開發價值,就會與原提案者討論,並著手進行提案書的製作與提案的工作。
三、 製作人產生提案書(Business Plan)
在進行BP的製作時,製作人必須充分的收集資料以達到足以說服投資者,說這個遊戲產品完成之後是可以獲利的,所以充分的市場分析資料的收集是必須的,與原提案者討論,並找出適合擔任監製的人,一起將遊戲規模或遊戲開發成本預估出來也是必須的,總之一切應該會如火如荼的展開中,最後再一次確認產品的目標與定位,把BP製作出來,製作的時間會隨著專案的大小而有所不同,根據日本遊戲廠商的經驗,平均大約是二週到一個月的製作時間,當然也可能會有例外啦,一切還是看專案的大小而定。
四、 專案正式成立&專案企劃階段(GDD&TDD)
接下來的階段就是要把遊戲內容設計出來的階段,將遊戲的內容設計出來簡單講就是將GDD(Game Design Document)【註一】完成,因為完成了GDD之後接下來就是要進行實際製作了,所以TDD(Technical Design Document) 【註二】也要一併完成才行,這個階段程式與美術領域的成員也正在著手進行前製工作,將內容設計到一個完整的程度就可以往下一個階段邁進,GDD的必須要將設計的工作完成,數值設計與調整的工作等到製作階段時再來進行,此時GDD會有的內容如下:
1. 遊戲名稱(Name Of Game)
2. 遊戲概觀(Game Overview)
I. 新的類型名稱(New Category Name)
II. 核心概念(Core Concept)
III. 獨特賣點(Unique Selling Point)
IV. 遊戲玩法(Game Play)
V. 消費者利益(Benefit)
3. 遊戲主要賣點(Key Feature)
4. 世界觀(World Setting)
5. 美術風格(Art Style)
6. 角色設計(Character)
7. 故事(Story)
8. 遊戲流程(Game Through)
9. 遊戲玩法設計(Game Play Design)
10. 道具設計(Item)
這個階段美術風格的執行方式與具體作法應該由美術監製確定出來了,各項準備工作也一一完成準備製作。
※ 註一:GDD(Game Design Document)就是詳細描述所有關於這個遊戲的內容的文件,在日本的遊戲業界稱作『ゲーム仕様書』,也就是遊戲規格書的意思,表示所有關於遊戲的設計內容都在裡面。
※ 註二:TDD(Technical Design Document)是將遊戲裡面會用到的所有與技術相關的部份記載並規範作法的文件,在大部份的軟體產業或科技產業也都有這一類的設計文件。
五、 試作版製作階段
進入這個階段會先挑選出一個關卡來進行試作,通常都會選擇第一關,因為第一關原本也會設計的較吸引人,拿來當作試作版本是再適合不過了,根據GDD的設計內容與TDD的規範內容來進行製作,企劃人員進行數值設計與調整,美術人員產生遊戲需要的資料與相關設計,程式人員則進行遊戲相關的功能製作。
1. 試作版的限制與規範
如何的一個內容才滿足試作版的需求,先從製作試作版的目的來瞭解比較快,製作試作版的目的是為了要在遊戲產品未完成之前,提前檢視遊戲產品到底好不好玩這件事,在製作的內容上面必須要是完整的一個關卡,才能完整看到遊戲的未來與全貌,所以試作版的限制並不是用時間來規範的,而是內容,試作版的內容規範如下:
I. 必須是完整的一個關卡,可以提供試玩的狀態。
II. 以強調遊戲的特色為主,並儘可能在短時間內製作出來。
試作版製作完成後仍需要接受審查,目的是能夠確保商品的銷售價值,一但發現無法順利進行下去,即使終止開發,所消耗的開發成本也能夠降低,不需等到產品完成之後才發現就晚了點。
六、 製作階段
1. 製作階段製作人的工作
接下來就是很明確的將產品製作出來的時期,這個時候,製作人就要開始忙別的事了,製作人必須再次整理之前提案的BP有關行銷的部份,並且與行銷人員將銷售戰略擬定出來,也必須開始尋找發行商,當然尋找發行商這件事並不是由這個階段才需要開始進行,如果有任何合適的機會點,都是可以持續進行的,只是到了這個階段就必須要很明確知道發行商是誰,這樣才能順利的將行銷戰略擬定出來;所以製作人很有可能長期不會出現在公司,製作的所有細節也會完全交由監製來負責,因為試作版、GDD、TDD都已經完成了,接下來就只有製作的部份,等到所有的東西都製作完成了,就會進入最後一個階段。
在製作期間有一些風險常會發生,很有可能遊戲的製作內容會因此而必須改變,這時就是考驗製作人與監製的判斷能力了,不過一些的決定還是會以製作人來做最後的確認,可能發生的風險簡列如下:
I. 發行商要求將發售日期提前或延後。
II. 發行商要求增加全新的玩法或項目。
III. 公司高層因為外來人士的建議,要求修改遊戲項目。
IV. 與遊戲產品幾乎相似的同質性產品上市了,被迫修改產品方向。
V. 仍然找不到發行商。
2. 企劃設計的工作與分野
在GDD已經到一個很明確的程度時,企劃人員接下來就是依據這些規划來進行設計的工作,在此時的企劃工作可以分成八個領域來進行:
I. 人物設計(Character Design)
遊戲中所有會用到的角色的設計,必須完成至圖像的部份,在GDD階段就會完成的部份。
II. 場景設計(Scene Design)
設計遊戲中使用場景及背景,包含地理位置、氣候等等,必須配合美術完成局部圖像的氣氛圖,在GDD階段就會完成的部份。
III. 戰鬥設計(Battle Design)
遊戲中所有玩法的設計,如果必須要使用道具的部份,也是要納入設計的部份,還必須包含手把控制器的輸入設計的部份,在GDD階段就會完成的部份。
IV. 故事(Story) 在已經在GDD中確定的故事大綱之下,將故事的細節含對話內容設計出來的工作。
V. AI設計(AI Design)
遊戲中與玩家的所有互動相關角色,都可以稱為AI,這些AI需要有什麼相關行為,及如何的與玩家互動,都是要被精心設計的,與程式的互動最密切,甚至連最基礎的程式用遊戲Data都需要提供,也必須要確認美術與程式間的資料是否滿足遊戲需求。
VI. 事件設計(Event Design)
依據故事的設計,就需要將故事溶入遊戲中,是否會新增加多的遊戲樂趣也是由事件設計來設計,新增的部份都不會影響到遊戲的主要玩法,而是以製作出遊戲的高潮迭起為首要目的,要讓玩家瞭解遊戲的劇情為主要目的。
VII. 介面設計(Interface Design)
負責遊戲中的所有介面設計,優先功能取向,再來考慮如何進行美化的動作,遊戲的流程在GDD完成時就定下了,圖像部份可能到了製作末期都還在修改,需考慮程式開出的相關限制來做設計,須吻合各遊戲平台的相關規定,也必須考量整體畫面的感覺是否恰當。
VIII. 關卡設計(Level Design)
明確定義出每個關卡的主題與想要發揮的方向,並以此為主題進行設計,必須與多個環節互相配合,最後將關卡呈現出來,必須要與程式人員與美術人員配合,提供所需的遊戲用資料,並進行調整。
前面三項的工作,在GDD完成時就已經完成了,接下來的工作會以細節設計、數值設計、資料提供與平衡調整為主。
七、 最後製作階段
當一切順利進行到最後製作階段時,製作人員應該已經累的一蹋糊塗了,此時正努力賣命工作的是遊戲的測試人員,此時發行商已經完全確定了,甚至連發售日期都已經明確的訂立下來,製作人則忙著與行銷人員完成銷售計劃與宣傳計劃,並與行銷人員緊鑼密鼓的執行中,一切都等著這個遊戲產品的上市上架,享受這一路來努力辛苦所完成的成功果實,製作人員在完成了這個階段後,就可以鬆口氣喘息一下,但是製作人與監製仍然不能閒下來,接下來最重要的工作就是去收集遊戲發售後的市場資料,以建立續作製作時的參考,或後續可能相關類型遊戲的參考數據。
這個階段的製作人員是可以好好喘息一下,以準備面臨下一次的專案考驗,休個假玩一玩或是充電一下都是不錯的選擇。
八、 遊戲販售&市場資料收集
遊戲終於如期發售了,所有人的辛苦總算有了回報,接下來就是要面臨殘酷的消費者考驗,到底會賣的如何呢?每一個成員都會期待銷售量越來越好,因為這也代表對製作團隊的肯定,但是一但賣的不好,可以也必須平心靜氣坐下來好好檢討一下問題在哪裡,所以必須著手收集市場資料來進行分析來能得知,還有另外一個需要檢討的是製作過程中是否有什麼問題造成一些無法彌補的後果,也會一併提出來檢討,比較適合召開會議的時間為遊戲發售後的一個月之後,此時遊戲的銷售數字與市場分析資料應該都比較齊全,就可以來召開檢討會議,會議由製作人召開,除製作人員外,由製作人邀請與選擇入席,檢討會議會討論的內容整理如下:
1. 遊戲目前的銷售數量。
2. 遊戲問卷調查結果分析。
3. 販售計劃與宣傳計劃的執行成效。
4. 實際開發成本與實際收入。
5. 遊戲製作過程的對與錯。
6. 之後的發展方向建議。
開完檢討會議後,專案真正告一段落,接下來製作人就準備再去提出下一個專案並繼續執行下去。